
AI가 없는 사실을 그럴듯하게 지어내는 것, 이걸 할루시네이션이라고 부릅니다. 저는 이게 시간이 해결해줄 문제라고 생각했어요. 모델이 더 좋아지면 자연히 사라질 성장통 같은 거라고요.
그런데 자료를 찾다가 생각을 고쳤습니다. 연구자들이 지목한 원인이 제가 짐작한 것과 아예 달랐거든요.
먼저 이게 뭔지 짚고 가면
할루시네이션은 AI가 모르는 걸 모른다고 하지 않고, 아는 것처럼 자신 있게 말하는 현상입니다. 없는 논문 제목을 만들어내거나, 존재하지 않는 법 조항을 인용하거나, 숫자를 슬쩍 바꿔 말하는 식이죠.
여기서 무서운 건 틀린다는 사실이 아니에요. 틀렸는데도 말투가 확신에 차 있다는 것. 우물쭈물하면 우리가 의심할 텐데, 너무 매끄럽게 말하니까 그냥 믿고 넘어갑니다.
제가 짐작했던 범인들
찾아보기 전에 저는 이렇게 생각했어요. 학습한 데이터에 틀린 정보가 섞여 있어서, 또는 모델이 아직 덜 똑똑해서.
둘 다 틀린 말은 아닙니다. 데이터 품질이나 모델 구조도 원인의 일부로 여전히 언급돼요. 그런데 이것만으로는 설명이 안 되는 게 있습니다. 모델이 세대를 거듭하며 훨씬 똑똑해졌는데도 이 버릇은 안 사라졌다는 것. 성능이 올라가면 줄어야 정상인데 말이죠.
연구가 지목한 진짜 범인: 채점표
2025년 9월 오픈AI 연구진이 낸 논문과, 이어서 나온 Nature 게재 연구가 같은 곳을 가리켰습니다. 범인은 모델이 아니라 모델을 평가하는 방식이었어요.
AI 성능을 재는 시험은 대부분 맞으면 1점, 틀리면 0점입니다. 여기에 중요한 게 하나 빠져 있어요. "모르겠습니다"에 주는 점수가 없습니다. 모른다고 답해도 0점, 엉뚱하게 찍어도 0점이에요.
그러면 어떻게 될까요. 계산해보면 답이 나옵니다.
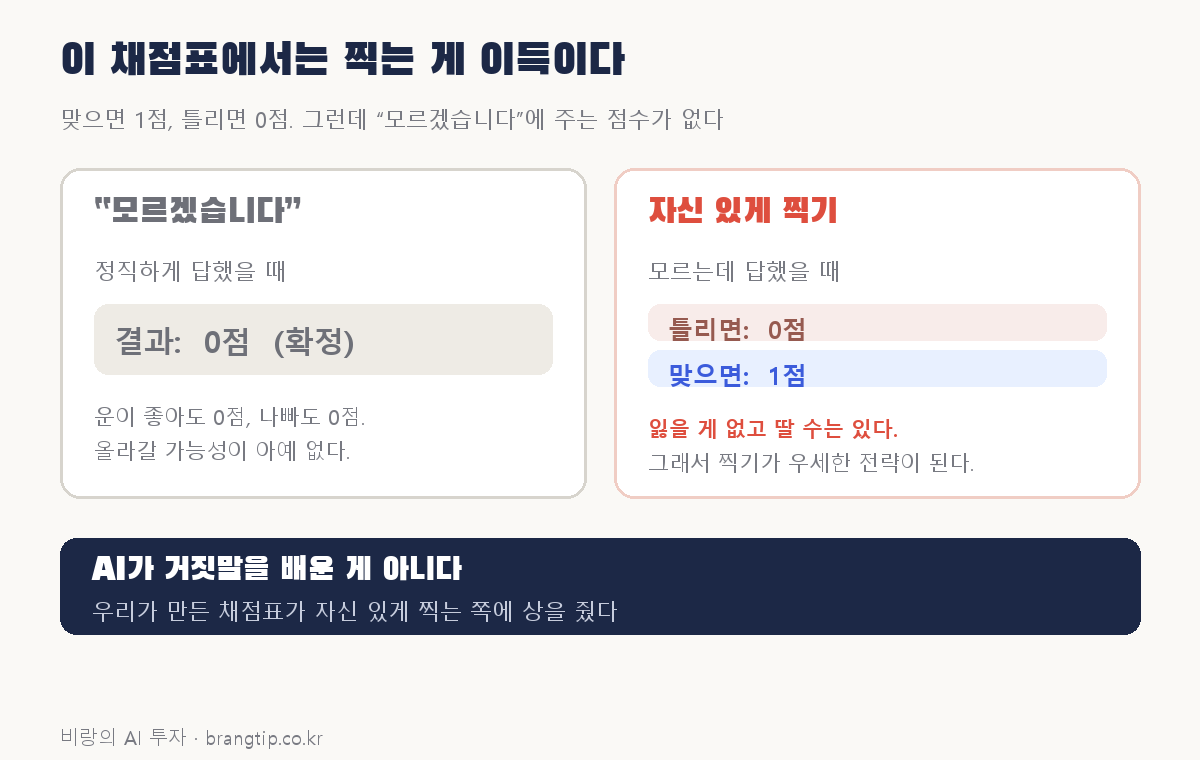
- 모른다고 하면: 확실하게 0점
- 찍으면: 틀리면 0점, 그런데 운 좋게 맞으면 1점
즉 찍는 쪽이 손해 볼 게 없습니다. 논문의 표현을 빌리면 이런 채점 아래에서는 찍기가 우세한 전략이 돼요. 정직하게 모른다고 말하는 모델은 점수표에서 밀립니다.
우리가 학창시절 객관식 시험에서 하던 짓과 똑같아요. 빈칸으로 두면 0점이니까, 모르면 일단 마킹은 했잖아요.
그래서 모델은 허세를 배운다
이렇게 보면 순서가 뒤집힙니다. AI가 못돼서 거짓말을 하는 게 아니라, 우리가 만든 채점표가 자신 있게 찍는 쪽에 상을 준 겁니다. 모델은 그걸 학습했을 뿐이고요.
그리고 이게 왜 잘 안 고쳐지는지도 설명됩니다. 순위표가 여전히 정답률로 줄을 세우는 한, 회사들은 정답률을 올리는 방향으로 모델을 다듬을 이유가 있어요. "모르겠다고 말하는 정직함"은 그 표에서 점수가 안 되니까요. 구조를 바꾸지 않으면 개별 모델만 바꿔서는 안 풀리는 문제라는 뜻입니다.
그럼 어떤 질문에서 특히 잘 나오나
이 원리를 알면 경계할 자리가 보입니다. 찍기는 아무 때나 나오는 게 아니라 모델이 아는 게 얕은 지점에서 나오거든요.
- 드물게 등장하는 고유명사: 유명한 사람은 잘 아는데, 덜 알려진 사람이나 회사, 지역 얘기로 내려가면 위험해집니다. 학습할 때 몇 번 못 본 이름일수록 찍을 확률이 올라가요.
- 논문 제목, 법 조항, 책의 몇 쪽 같은 것: 형식이 뻔한 정보가 제일 위험합니다. 그럴듯한 모양을 만들어내기가 너무 쉬워서요. 있어 보이는 제목과 저자 이름을 조합하는 건 모델에게 어려운 일이 아닙니다.
- 최근 일어난 일: 학습 시점 이후의 사건은 알 수가 없는데, 모른다고 하는 대신 그럴듯한 얘기로 메꿀 수 있어요.
- 정확한 숫자: 대략의 규모는 맞히면서 소수점이나 단위를 슬쩍 바꿔 말하는 경우가 있습니다. 앞자리가 맞으니까 더 안 의심하게 되죠.
반대로 개념 설명이나 글 다듬기, 아이디어 정리처럼 정답이 하나로 정해져 있지 않은 일은 이 위험이 훨씬 낮습니다. 애초에 찍을 게 없는 질문이니까요.
그럼 우리가 지금 할 수 있는 건
연구가 지목한 게 채점 방식이라면, 사용자 입장에서 손댈 수 있는 건 채점표를 내가 다시 써주는 것입니다. 질문에 이런 조건을 붙이는 거예요.
- "모르면 모른다고 답해도 된다"고 먼저 허락하기. 이 한 줄이 의외로 큽니다. 찍어야 할 이유를 없애주는 거니까요.
- "확실한 것과 추측을 구분해서 표시해달라"고 요구하기. 섞여 나오는 게 제일 위험한데, 나눠 달라고 하면 대개 나눠줍니다.
- 출처를 같이 달라고 하기. 근거를 요구하면 없는 얘기를 만들 여지가 줄고, 내가 확인할 수 있는 실마리가 생겨요.
- 날짜·금액·고유명사는 여전히 사람이 확인하기. 이건 요령이 아니라 습관 문제입니다.
3번을 아예 기본 동작으로 삼는 도구도 있어요. 질문에 조건을 붙여 답의 범위를 좁히는 요령은 프롬프트 글에 더 담아뒀습니다.
정리하며 남는 찜찜함
솔직히 이 글을 쓰면서 마음이 편해지진 않았어요. 원인이 채점표라는 건, 우리가 도구를 잘 써서 피할 수 있는 문제가 아니라는 뜻이기도 하니까요. 업계가 평가 방식을 고치기 전까지는 이 버릇이 계속 남아 있을 거예요.
그래도 하나는 분명해졌습니다. AI가 자신 있게 말한다는 건 그게 맞다는 신호가 아니라, 그렇게 말하도록 훈련받았다는 신호라는 것. 저는 이걸 알고 나서 확신에 찬 문장을 볼 때 오히려 한 번 더 멈추게 됐어요.